
Vo firmách stále prevažuje vyžívanie metód zameraných na odhalenie príčin vzniknutých problémov, ktoré sú subjektívneho charakteru. Mám na mysli brainstorming, Ishikawa, Afinitný diagram, či mnohé ďalšie, pomocou ktorých sa snažíme z prítomných „vypáčiť“ ich názor na vzniknutý problém. Následne tieto poväčšine subjektívne dojmy kategorizujeme, spočítame a zostavíme poradie. Existujú však aj metódy, ktoré ponúkajú objektívny, kvantitatívne vyjadrený výsledok, interpretovaný na základe faktov.
Korelácia a regresia
V predošlých častiach sme na jednoduchých príkladoch aplikovali vybrané testy hypotéz (jedno-výberový t test, dvoj-výberový proporčný test, n proporcií), za účelom posúdenia predpokladu formulovaných hypotéz s určitým stupňom spoľahlivosti.
Testovanie hypotézy je tiež súčasťou rozhodovacej procedúry o vzájomnej interakcii dvoch alebo viacerých faktorov v korelačnej analýze.
Pri korelácii meriame hodnoty znakov medzi ktorými existuje funkčná závislosť y = f(x), kde:
- x je nezávisle premenná
- y je závisle premenná
Posudzujeme n párov hodnôt (x1, y1), (x2, y2),…, (xn, yn).
Úlohou korelačnej analýzy je nielen posúdiť vzájomný vzťah vyšetrovaných faktorov, ale tiež kvantitatívne vyjadriť silu závislosti.
Štatisticky sa lineárny vzťah medzi dvoma premennými popisuje koeficientom korelácie (rxy). Ten môže nadobúdať hodnoty od -1 do +1.
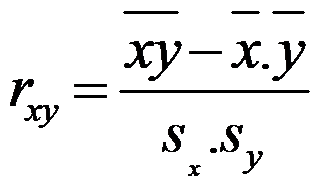
Po dosadený do vzorca a vypočítaní hodnoty rxy môžu nastať nasledovné situácie:
- Pozitívna korelácia, keď rxy = 1.
- Znamená to, že vyšším hodnotám x odpovedajú vyššie hodnoty y alebo nižším hodnotám x odpovedajú nižšie hodnoty y.
- Negatívna korelácia, keď rxy = -1.
- Znamená to, že vyšším hodnotám x odpovedajú nižšie hodnoty y alebo nižším hodnotám x odpovedajú vyššie hodnoty y.
- Žiadna korelácia, keď rxy = 0.
- Nie je medzi x a y závislosť ( presnejšie nie je závislosť vyjadrená lineárnou funkciou).
- Výsledok ľubovoľného čísla od -1 do 1.
- čísla blízke 1 vyjadrujú pozitívnu koreláciu (od 0,75 tvrdíme, že silnú pozitívnu)
- čísla blízke -1 vyjadrujú negatívnu koreláciu
- čísla okolo 0 skôr vypovedajú o nezávislosti
Pri výpočtoch koeficientu korelácie sa zároveň realizuje test nezávislosti v podobe hypotézy:
H0: rxy = 0 (korelačný koeficient je rovný nule)
H1: rxy ≠ 0
- Výstupom testovania hypotézy o hladine významnosti skúmanej závislosti je hodnota p
- p ˃ 0,05, prijímame hypotézu nezávislosti (koeficient korelácie = 0)
- Čím je táto hodnota bližšia k 1, nezávislosť sa preukazuje výraznejšie.
- p ˂ 0,05, prijímame hypotézu závislosti (koeficient korelácie je rôzny od 0)
- p ˃ 0,05, prijímame hypotézu nezávislosti (koeficient korelácie = 0)
Skúsme si modelovať korelačnú analýzu na praktickom príklade.
Spoločnosť vyrábajúca plastové výlisky, posudzuje ich životnosť skúškou tvrdosti po určitom čase. Posudzovalo sa 12 výrobkov, každý z nich po určitom čase. Hľadáme odpoveď na závislosť medzi tvrdosťou výrobku (y) na čase (x), ktorý uplynul od vylisovania (v hodinách).
Vstupné údaje reprezentujúce výsledok skúšky:
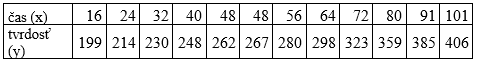
Riešenie:
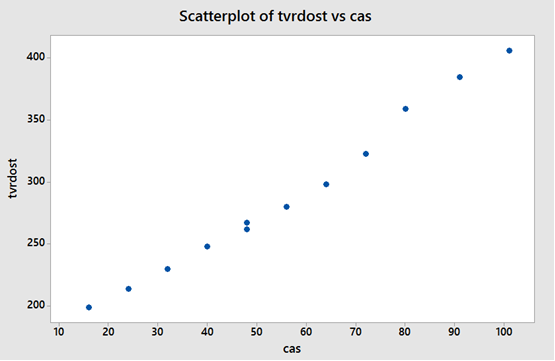
V prvom kroku sa pokúsime vyjadriť závislosť graficky pomocou scatter plot. Z grafu je jasne čitateľná lineárna závislosť tvrdosti na čase. S rastom času rastie i tvrdosť výlisku.
V druhom kroku sa pokúsime overiť kvantitatívne na základe hypotézy, či je skutočne vzťah medzi tvrdosťou a časom. Ak hypotézou potvrdíme vzájomný vzťah, bude nás zaujímať ako silný tento vzťah je.
Riešenie:
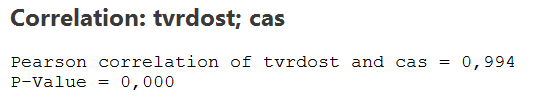
Keďže p hodnota ≤ 0,05 (náš výsledok p=0,000) prijímame hypotézu závislosti (koeficient korelácie je rôzny od 0).
Korelačný koeficient je 0,994 teda posudzovaný vzťah vyjadríme ako silne pozitívny!
Mnohých by možno zaujímala otázka, ako sa bude vyvíjať tvrdosť výlisku resp. akú hodnotu tvrdosti možno očakávať po 200 hodinách?
Otázku predikovania budúceho stavu možno zodpovedať regresnou analýzou.
Lineárna Regresia modeluje lineárnu závislosť medzi premennými, keď jedna premenná priamo závisí od druhej. Používa sa pri spojitej závislej premennej Y a jednej alebo viacerých premenných od ktorých Y závisí.
Regresia kvantitatívne popisuje vzájomný vzťah dvoch premenných cez tzv. model, ktorý je matematickým vyjadrením tohto vzťahu. Pre jednoduchý lineárny regresný model platí:
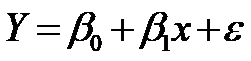
Riešenie:
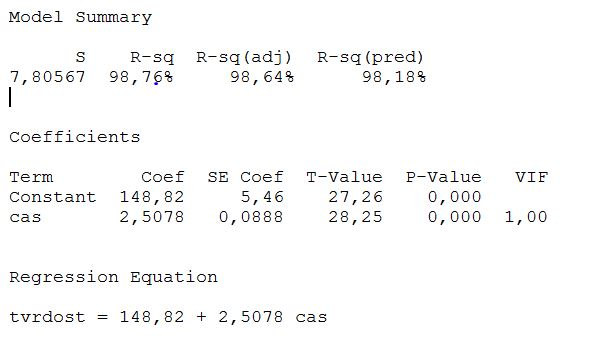
Pri pohľade na výsledok regresnej analýzy musíme zodpovedať nasledovné otázky:
- Je model štatisticky prípustný?
- Aký je podiel modelom vysvetlenej variability?
- Aký je konkrétny tvar modelu?
- Koľko vychádza hodnota závislej premennej Y pri zadanej hodnote X?
- V ktorej oblasti hodnôt sa môže model použiť?
V interpretácii výsledku nášho príkladu sa obmedzím len na zodpovedanie otázky č.4 očakávanej tvrdosti po 200 hodinách.
Po dosadení do rovnice, dostaneme odpoveď na očakávanú tvrdosť s hodnotou 650,38.
Tvrdosť = 148,82 + 2,5078. 200hod = 650,38
Pozor:
Nebojte sa s dátami experimentovať, ale:
- To, že sme prijali pri korelácii H1 hovorí len, že koeficient rxy je rôzny od 0, ale nič nehovorí
- stupni tejto závislosti medzi x a y.
- stupni závislosti hovorí veľkosť, alebo ,,malosť,, hodnoty koeficientu korelácie rxy
- Závery vychádzajú s dostatočne veľkej reprezentatívnej vzorky / vzoriek (pre regresiu aspoň
- 30 párov údajov)
- Pri regresii je dôležité zodpovedať štatistickú prípustnosť modelu a vyššie naznačených 5 otázok
„Časť informácií obsiahnutých v článku je zobrazená so súhlasom spoločnosti Minitab Inc. Všetky takéto materiály zostávajú výlučným vlastníctvom a autorskými právami spoločnosti Minitab Inc. Všetky práva vyhradené.“